Python如何批量将csv文件编码方式转换为UTF-8?下面就给大家解答
csv文件其实就是单纯的储存文本数据的一种形式,那么,在日常的办公当中,要怎么做去提高其办公的效率呢?比如,如何使用Python去批量的进行处理文件,批量的处理csv文件,怎么将编码转换成为YTF 8的形式呢?下面给大家详细的解答下。 当我们用pandas是操作CSV文件的时候,常常会因为编码问题出现报错。 panda
来源: https://www.ucloud.cn/yun/128366.html 作者: 89542767 发布日期: 发布于2022-11-16 14:52
csv文件其实就是单纯的储存文本数据的一种形式,那么,在日常的办公当中,要怎么做去提高其办公的效率呢?比如,如何使用Python去批量的进行处理文件,批量的处理csv文件,怎么将编码转换成为YTF-8的形式呢?下面给大家详细的解答下。
当我们用pandas是操作CSV文件的时候,常常会因为编码问题出现报错。
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader.read()
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader._read_low_memory()
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader._read_rows()
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader._convert_column_data()
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader._convert_tokens()
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader._convert_with_dtype()
pandas_libsparsers.pyx in pandas._libs.parsers.TextReader._string_convert()
pandas_libsparsers.pyx in pandas._libs.parsers._string_box_utf8()
UnicodeDecodeError:‘utf-8’codec can’t decode byte 0xca in position 0:invalid continuation byte
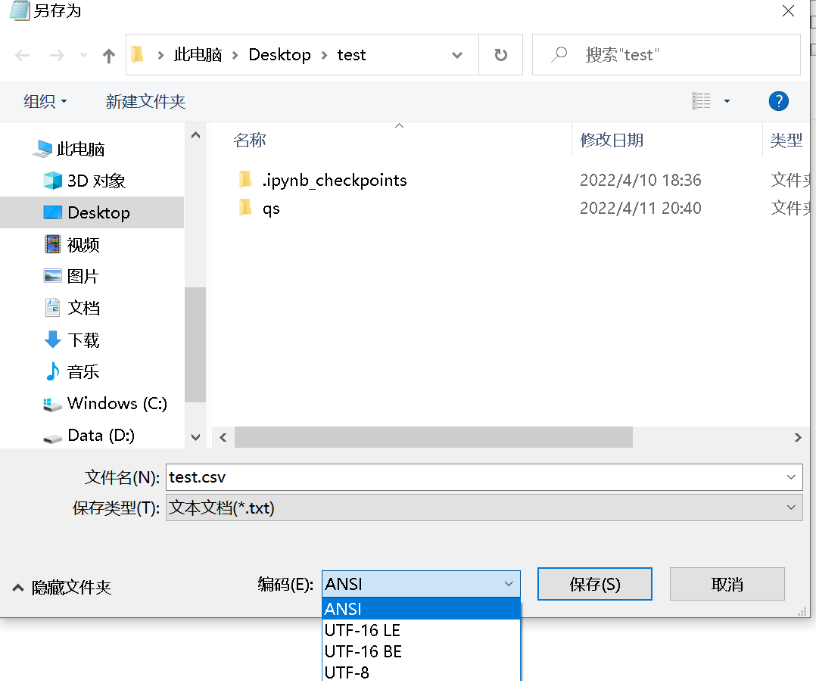
如果只是一两个文件,我们可以用系统自带记事本的方法进行解决:
1、右键csv文件,打开方式选择“记事本”打开;
2、ctrl+shift+s另存为,将编码方式由ansi给改为UTF-8,点击确定并替换原文件。
嫌麻烦的也可以在每次用pandas读取csv前加入以下代码。
  import pandas as pd
  filename='222.csv'
  try:
  df=pd.read_csv(filename,encoding='utf-8')
  except BaseException:
  df=pd.read_csv(filename,encoding='cp950')
  df.to_csv(filename,encoding='utf-8',index=False)
如果很多类似的ASCII的CSV文件就会非常头痛,下面我们用Python编写一个程序,用来检测并批量转换csv文件的编码方式。
需要指出的是,这个程序并不完善,运行速度没有进行优化,并且仍然有部分文件未能转换成功,但足以应对日常的分析需要。经过尝试,有几种csv文件无法转换:
1、包含图片或者图表的csv文件
2、原先的csv文件内容就是乱码的
觉得有帮助,那请给这篇文章点个赞吧❤️
演示效果:
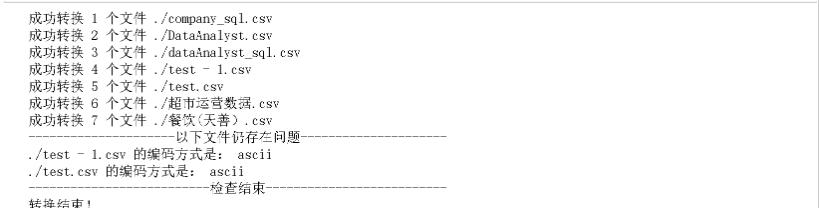
代码:
  import os
  from chardet.universaldetector import UniversalDetector
  def get_filelist(path):
  """
  获取路径下所有csv文件的路径列表
  """
  Filelist=[]
  for home,dirs,files in os.walk(path):
  for filename in files:
  if".csv"in filename:
  Filelist.append(os.path.join(home,filename))
  return Filelist
  def read_file(file):
  """
  逐个读取文件的内容
  """
  with open(file,'rb')as f:
  return f.read()
  def get_encode_info(file):
  """
  逐个读取文件的编码方式
  """
  with open(file,'rb')as f:
  detector=UniversalDetector()
  for line in f.readlines():
  detector.feed(line)
  if detector.done:
  break
  detector.close()
  return detector.result['encoding']
  def convert_encode2utf8(file,original_encode,des_encode):
  """
  将文件的编码方式转换为utf-8,并写入原先的文件中。
  """
  file_content=read_file(file)
  file_decode=file_content.decode(original_encode,'ignore')
  file_encode=file_decode.encode(des_encode)
  with open(file,'wb')as f:
  f.write(file_encode)
  def read_and_convert(path):
  """
  读取文件并转换
  """
  Filelist=get_filelist(path=path)
  fileNum=0
  for filename in Filelist:
  try:
  file_content=read_file(filename)
  encode_info=get_encode_info(filename)
  if encode_info!='utf-8':
  fileNum+=1
  convert_encode2utf8(filename,encode_info,'utf-8')
  print('成功转换%s个文件%s'%(fileNum,filename))
  except BaseException:
  print(filename,'存在问题,请检查!')
  def recheck_again(path):
  """
  再次判断文件是否为utf-8
  """
  print('---------------------以下文件仍存在问题---------------------')
  Filelist=get_filelist(path)
  for filename in Filelist:
  encode_info_ch=get_encode_info(filename)
  if encode_info_ch!='utf-8':
  print(filename,'的编码方式是:',encode_info_ch)
  print('--------------------------检查结束--------------------------')
  if __name__=="__main__":
  """
  输入文件路径
  """
  path='./'
  read_and_convert(path)
  recheck_again(path)
  print('转换结束!')
核心代码是:
  def get_encode_info(file):
  """
  逐个读取文件的编码方式
  """
  with open(file,'rb')as f:
  detector=UniversalDetector()
  for line in f.readlines():
  detector.feed(line)
  if detector.done:
  break
  detector.close()
  return detector.result['encoding']
  Filelist=get_filelist(path=path)
  fileNum=0
  for filename in Filelist:
  try:
  file_content=read_file(filename)
  encode_info=get_encode_info(filename)
  if encode_info!='utf-8':
  fileNum+=1
  convert_encode2utf8(filename,encode_info,'utf-8')
  print('成功转换%s个文件%s'%(fileNum,filename))
  except BaseException:
  print(filename,'存在问题,请检查!')
总结
综上所述,这篇文章就给大家介绍到这里了,希望可以给大家带来帮助。