竞品调研怎么做才经得起追问?我用五份官方资料、十五项对比跑了一遍
截图存了一整个文件夹,表格也拉过几张,等到要交东西的时候被问一句「这三家差别到底在哪、适合谁、依据是什么」,你还得回去翻资料。问题不在你收集得少,而在每一条结论背后没有一条能拽回原句的线索。
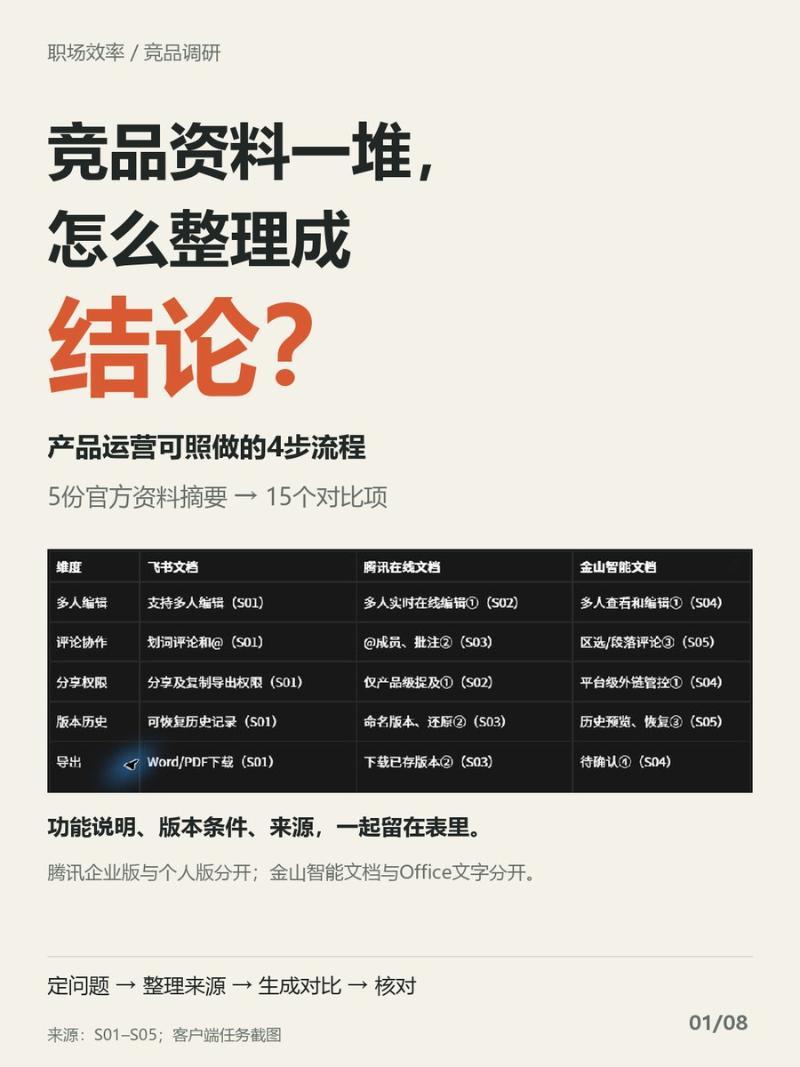
我拿一个具体场景练了一遍:小团队共同维护项目文档,候选是飞书文档、腾讯文档、金山文档。把五份官方资料摘要放进优刻得星图 AstraFlow,最终整理出五个维度、十五个对比项。整个过程拆成四步:定问题、整理来源、生成对比、换模型核对。
核心要点
- 调研最容易垮的地方在开头:问题模糊,找回来的资料就拼不成结论。
- 四步里真正费时间的不是第三步生成,而是第二步整理来源和第四步核对。
- 每份材料进来之前先补齐四个字段,其中「适用版本」最关键。
- 官方文档没写清楚的功能统一标成「待确认」,不等于「不支持」。
- 两个模型给出同一个答案,不等于答案是对的,定稿仍需人工回到原句核验。
一、先定问题:范围定死,维度才好定
调研最容易垮的地方在开头。拿着一个模糊的需求去找资料,最后一定会找回来一堆看起来都有用、但拼不成结论的东西。所以要从「要回答什么问题」倒着推。
这一轮锁定的范围是 Web 端的文字协作,桌面客户端、移动端、表格和幻灯片类型全部排除在外。范围定死了,维度才好定,最终列出五个维度。这五个维度不是拍脑袋想的,是从「一个团队一起维护一份文档」这个动作里拆出来的——真的和人一起改过文档就会知道,日常会遇到的麻烦基本就这五类。
还有一件事必须做,就是统一口径。口径里有三个变量要一起记下来:
| 变量 | 取值示例 | 不对齐的后果 |
|---|---|---|
| 终端 | Web 端 / 客户端 | 功能可用性判断失真 |
| 文档类型 | 文字 / 表格 | 能力对比错位 |
| 账号版本 | 个人版 / 企业版 | 权限与套餐结论失效 |
这三个变量里任何一个没对齐,后面那张对比表就是废的。这是整个流程里最容易翻车的地方。
⟦IMG-2⟧
先定问题,再找资料。这一页是整个流程的地基,地基没打,后面三步全白做。
二、给 AI 资料,也给它来源
这一步是四步里最不性感、但收益最大的一步。大多数人给 AI 丢资料的姿势,是把 PDF 或者网页直接甩进去,然后说「帮我总结一下」。这样出来的东西,你没办法知道哪句话是从哪来的。
正确的做法是:每份材料进来之前先补齐四个字段。以这一轮采集的第三份材料——腾讯文档企业版的用户操作指南——为例,记录如下:
- 来源链接:http://cloud.tencent.com/document/product/1663/103166
- 文档类型:在线文档(文字)
- 适用版本:腾讯文档企业版(SaaS)
- 采集编号:S03
四个字段里最重要的是适用版本。官方文档经常不区分个人版和企业版,你读的时候觉得很顺,真去用的时候才发现它说的是另一个版本。这个坑踩过不止一次。
这里还有一条纪律:官方文档没写清楚的功能,不要让它滑过去,也不要让 AI 补齐。统一标成 「待确认」。待确认不等于不支持,它只表示这份材料里没写。这两个状态一旦混在一起,后面所有的结论都会失真。
这一轮的五个来源全部编号,从 S01 到 S05,后面每一个结论都能顺着编号查回去。
⟦IMG-3⟧
资料没有说清的,回到来源继续核对。这一步的全部意思就是这个。
三、整理成同一张表:让 AI 按统一维度干活
前三步做完,才轮到让 AI 干活。使用的工具是优刻得星图 AstraFlow——UCloud 优刻得旗下一站式 AI 开发平台,模型市场里聚合了两百多个主流大模型,另外自带一个沙箱环境用来跑 Agent 任务。
这一轮只用到两件事:一是在客户端里直接整理任务,二是在同一个会话里切换大模型。
- 输入:五份官方资料摘要(S01–S05)
- 输出:五个维度 × 三款产品 = 十五个对比项,每一项都挂着来源编号
这张表是整件事的重点,拆开说四点:
- 每一格后面都带来源编号。 这不是装饰,它的作用是让读报告的人能顺着编号查回原句,而不是只能选择相信你。
- 初稿标引用位置,定稿统一换成来源编号。 位置标记只对做表的人有意义,编号对看表的人才有意义。
- 同一行里三家的颗粒度可能差很远。 同样是分享权限这一行,飞书是功能级描述,腾讯只在产品级提了一句,金山是平台级的外链管控。这种粗细不齐的情况,AI 压不平,只能如实标出来。
- 内容横向铺太开,手机上看就是灾难。 所以宽表之外,再压一版短表,每一格只留结论和来源编号。
⟦IMG-4⟧
统一字段,才方便横向比较。
四、换个模型核对:模型辅助检查,人核对依据
这一步是最容易被跳过、也最不该跳过的一步。初稿由 DeepSeek V4.1 Flash 生成;核对时在同一个会话里切到 GLM 5.2,把相同的资料和初稿一起给它。
核对时重点看三件事:
- 来源是否支持原句。
- 个人版与企业版是否混比。
- 文档类型与导出格式是否套错。
这一轮 GLM 5.2 提了一个认可的修改:把「产品级」和「平台级」这两个词的用法统一了,让腾讯的产品简介和金山平台总述不再混成一类表述。
但这里有一条底线要说清楚:两个模型给出同一个答案,不等于这个答案是对的。 它只说明这两个模型在同样的材料上得到了相似的结论。真要定稿,还是得回到 S01 到 S05 那五份材料里,人工核一遍原句。
复核这一步的分工是:模型负责辅助检查,人负责核对依据。
⟦IMG-5⟧
五、交付时把依据带上
调研做完了,交付物本身也要能自证。做法是把结论和依据放在一起交:表还是那张表,每一格下面挂着来源编号;表下面跟一段注释,把这一轮的边界写清楚。
具体的注释有四条:
- 腾讯 S03 只覆盖企业版,S02 和金山 S04 都是概括性介绍。
- 金山 S05 只说明了智能文档的历史面板,而且需要编辑权限。
- 套餐、当前权益和具体导出格式,还要按账号逐项核对。
- S01 没有逐项说明套餐,没写不等于不支持。
最后给一句结论:已有的依据可以形成清单;如果要做正式选型,还需要补齐同版本、同角色的验证。这句话看起来像在示弱,其实不是——它是在告诉读报告的人,这份材料的有效期和适用范围在哪里。
⟦IMG-6⟧
让看报告的人也能顺着来源查回去,这句话是交付环节的全部要求。
六、哪些交给 AI,哪些自己做
走完四步,分工的边界更清楚了。
| 交给 AI 的三类活 | 自己负责的三类活 |
|---|---|
| 按统一维度整理资料 | 确定业务问题 |
| 汇总已有材料里的差异 | 核对来源与适用版本 |
| 草拟表格和结论 | 判断差异是否影响决策 |
前一类是体力活,做得快、做得齐、做得不知疲倦。后一类是判断活,做不快,但没人能替你做。表格整理完,你还要回答的那个问题是:这对业务意味着什么。
用优刻得星图 AstraFlow 把前一类接过去,省下来的时间不是让你多整理两份资料,是把注意力留给判断。
⟦IMG-7⟧
七、这段提示词,换题也能用
这一轮用的提示词留在这里,换掉业务问题就能继续用。其中最有用的两段是:
- 让 AI 按统一维度整理资料,并给每个结论标注来源编号。
- 让 AI 在同一个会话里切换模型,用不同模型交叉核对初稿。
⟦IMG-8⟧
- 「没有依据的内容不要推断」——这一句能挡掉大部分看起来很像那么回事、但你查不回去的内容。
- 「将事实与判断分开」——这一句能让 AI 输出的东西自带标注,你一眼能看出哪些是材料里写着的,哪些是它的推断。
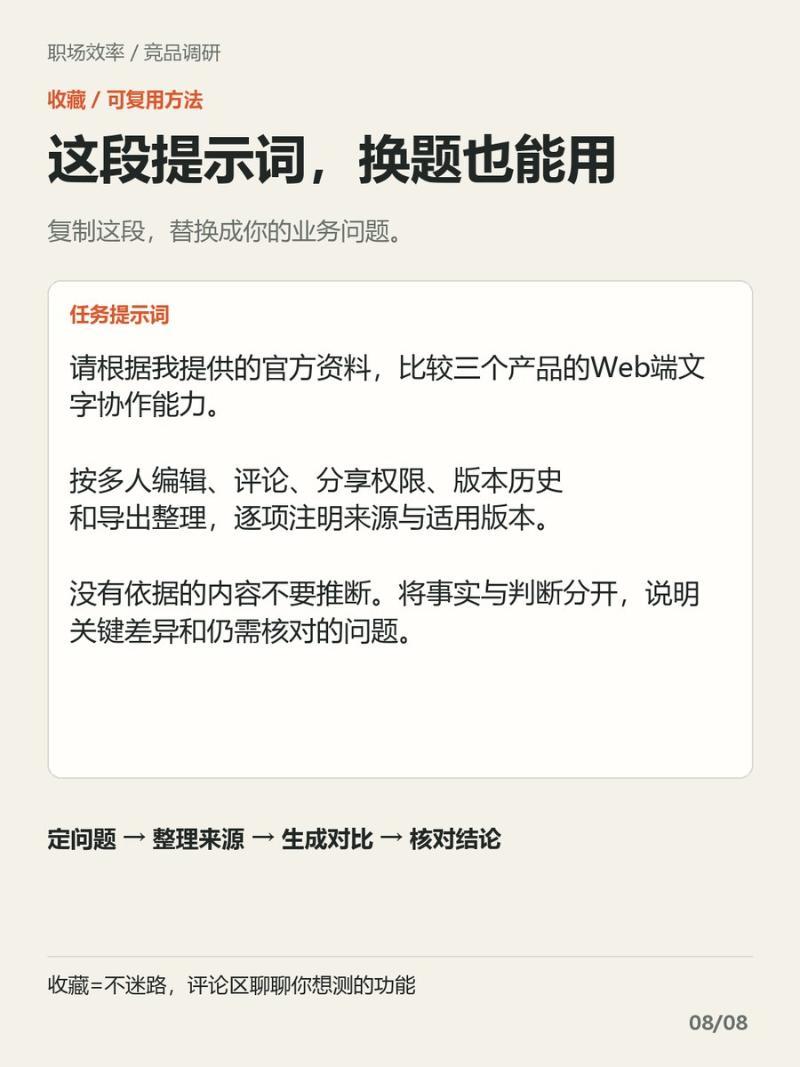
定问题,整理来源,生成对比,核对结论。四步走完,一份调研才算能交出去。
常见问题(FAQ)
Q1:为什么说「待确认」不等于「不支持」? A:待确认只表示这份材料里没写,是来源覆盖度的问题;不支持是功能层面的结论。两者混在一起,后面所有结论都会失真。
Q2:两个模型都给出同一个答案,可以定稿吗? A:不可以。两个模型结论一致,只说明它们在同样的材料上得到了相似结论,不等于答案正确。定稿仍需回到 S01–S05 原始材料人工核验原句。
Q3:为什么定稿要把「引用位置」换成「来源编号」? A:位置标记只对做表的人有意义,编号对看表的人才有意义。编号让读报告的人能顺着线索查回原句。
Q4:宽表和短表要同时保留吗? A:建议同时保留。宽表承载完整信息,短表每格只留结论和来源编号,解决手机端阅读的横向铺开问题。
Q5:这套流程换到别的选型场景还能用吗? A:可以。四步流程和提示词与具体品类无关,换掉业务问题和候选清单即可复用。
最后
用下来的感受是,资料、结果和模型选择留在同一个工作台里,来回改的时候比较顺手,不用在几个网页之间倒腾,思路不容易断。
但有件事得说清楚:来源和版本仍然要你自己查。 腾讯企业版不能直接当个人版来比,金山智能文档也不能和 Office 文字混在一起比。这类判断 AI 帮不了你,因为它的依据本来就是你给它的。
用优刻得星图 AstraFlow 这类工具辅助整理,省下的是收集和排版的力气,不是判断的责任。把注意力留给判断,这句话说起来轻,做起来就是那两步最不性感的活。