一次生产核心表Optimize table的操作经历
一次生产核心表Optimize table的操作经历 前 言 系统运行了一年多,有几张表特别大。前期经过了一些测试,发现使用Optimize Table命令能够回收空间,而且能够在线操作,于是决定在晚上找闲时操作一下。 前期测试 在前期我们对这个操作进行了详尽的测试。包括回收的方式,回收的速度,以及是否产生锁等情况。我
来源: https://www.ucloud.cn/yun/129909.html 作者: IT那活儿 发布日期: 发布于2023-01-11 13:20
一次生产核心表Optimize table的操作经历
前 言
系统运行了一年多,有几张表特别大。前期经过了一些测试,发现使用Optimize Table命令能够回收空间,而且能够在线操作,于是决定在晚上找闲时操作一下。
前期测试
在前期我们对这个操作进行了详尽的测试。包括回收的方式,回收的速度,以及是否产生锁等情况。我们测试的方法是找到一张表,循环删除若干条记录,然后进行回收,在回收期间执行了一个循环更新的脚本,观察更新过程中是否出现锁的情况。
而我们基于测试的结果得出的结论如下:
- 通过测试发现对大表进行Optimize Table不会阻塞DML语句,它只会在文件发生切换的时候短暂锁表。
- 表上索引很多的情况,执行Optimize Table会很慢,建议评估表空间回收后的大小,如果回收之后表变得较小,建议删除索引之后进行操作。通过测试删除索引后速度能快一倍。
- 在执行optimizer table的时候,从库会一直延迟,直到主库完成操作,从库才会开始操作optimizer table。
正式操作
到了正式操作的时候,我们按照测试的结果进行执行。前期都较为顺利。大概在操作了1个小时之后,突然出现监控连接数告警。
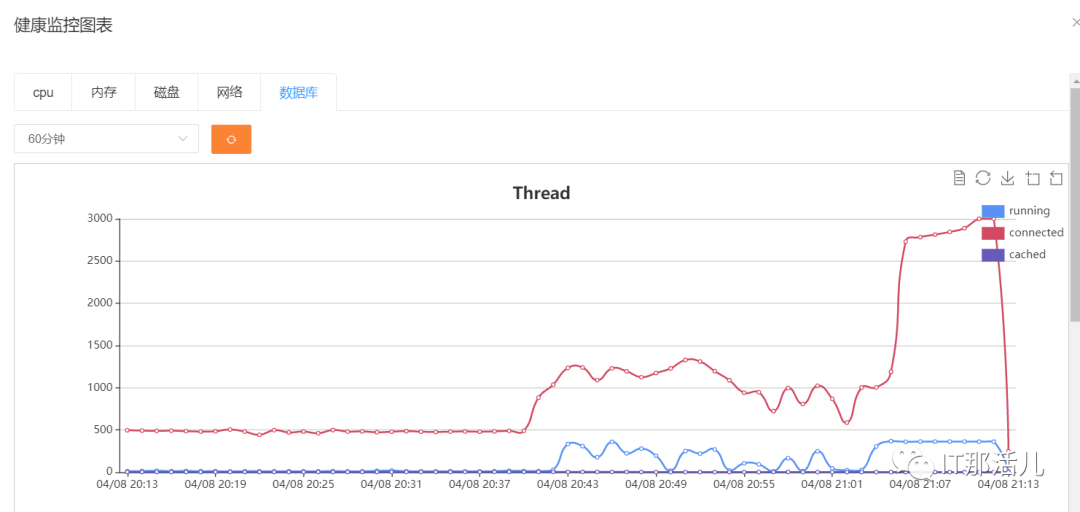
可以看到当前我们设置最大的Thread数量为3000。结果瞬间达到了最大值。
通过命令行进入到数据库。发现大量的查询语句在等待Waiting for table metadata lock。
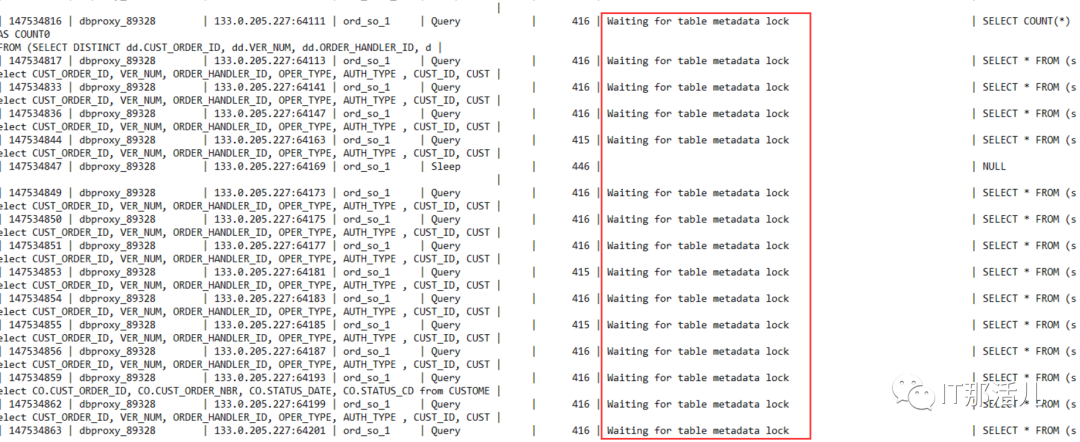
这些查询语句也都在查询我们操作Optimize Table的表。没有任何办法数据库就这样全局hang死了。不停的有连接上来执行查询操作,就要等待这个Waiting for table metadata lock。只能把源头Optimize Table停掉。在停掉了之后,系统立马恢复了正常。
问题回溯
在这次操作的过程中,其实前期也有完整的测试,但是还是出现了这样的情况,一个很大的原因是我们没办法模拟生产的负载情况。
应用程序还有一个特点,一旦堵塞了住了,就会不停的连接,这样的程序其实就是一个疯狂压测程序。
所以做这样的测试,需要我们思考到一点:
我们需要捕捉到生产的流量,然后在测试的时候进行回放重演。
那么怎么进行流量的捕捉,一个简单的方法就是使用tcpdump捕捉3306端口的信息。然后使用解析出数据,进行重演。此类方案比较多,比较令人熟悉的是tcpcopy这个解决方案。
问题解决
那么最终的一个解决办法就是,我们可以先在从库上进行操作。这里的操作需要加上sql_log_bin = 0不记录binlog日志。等从库回收之后,再找个机会进行主从切换。
END
更多精彩干货分享
点击下方名片关注
IT那活儿